Securitate

AI Assistant

Un model de limbaj care rulează pe serverul firmei și răspunde cu datele din Monolit, fără să trimită nimic în afară.

Versiune
1.1.0
Stadiu
Stabil
Capturi
3
Înlocuiește
Asistenți AI în cloud, cu datele firmei trimise în afară
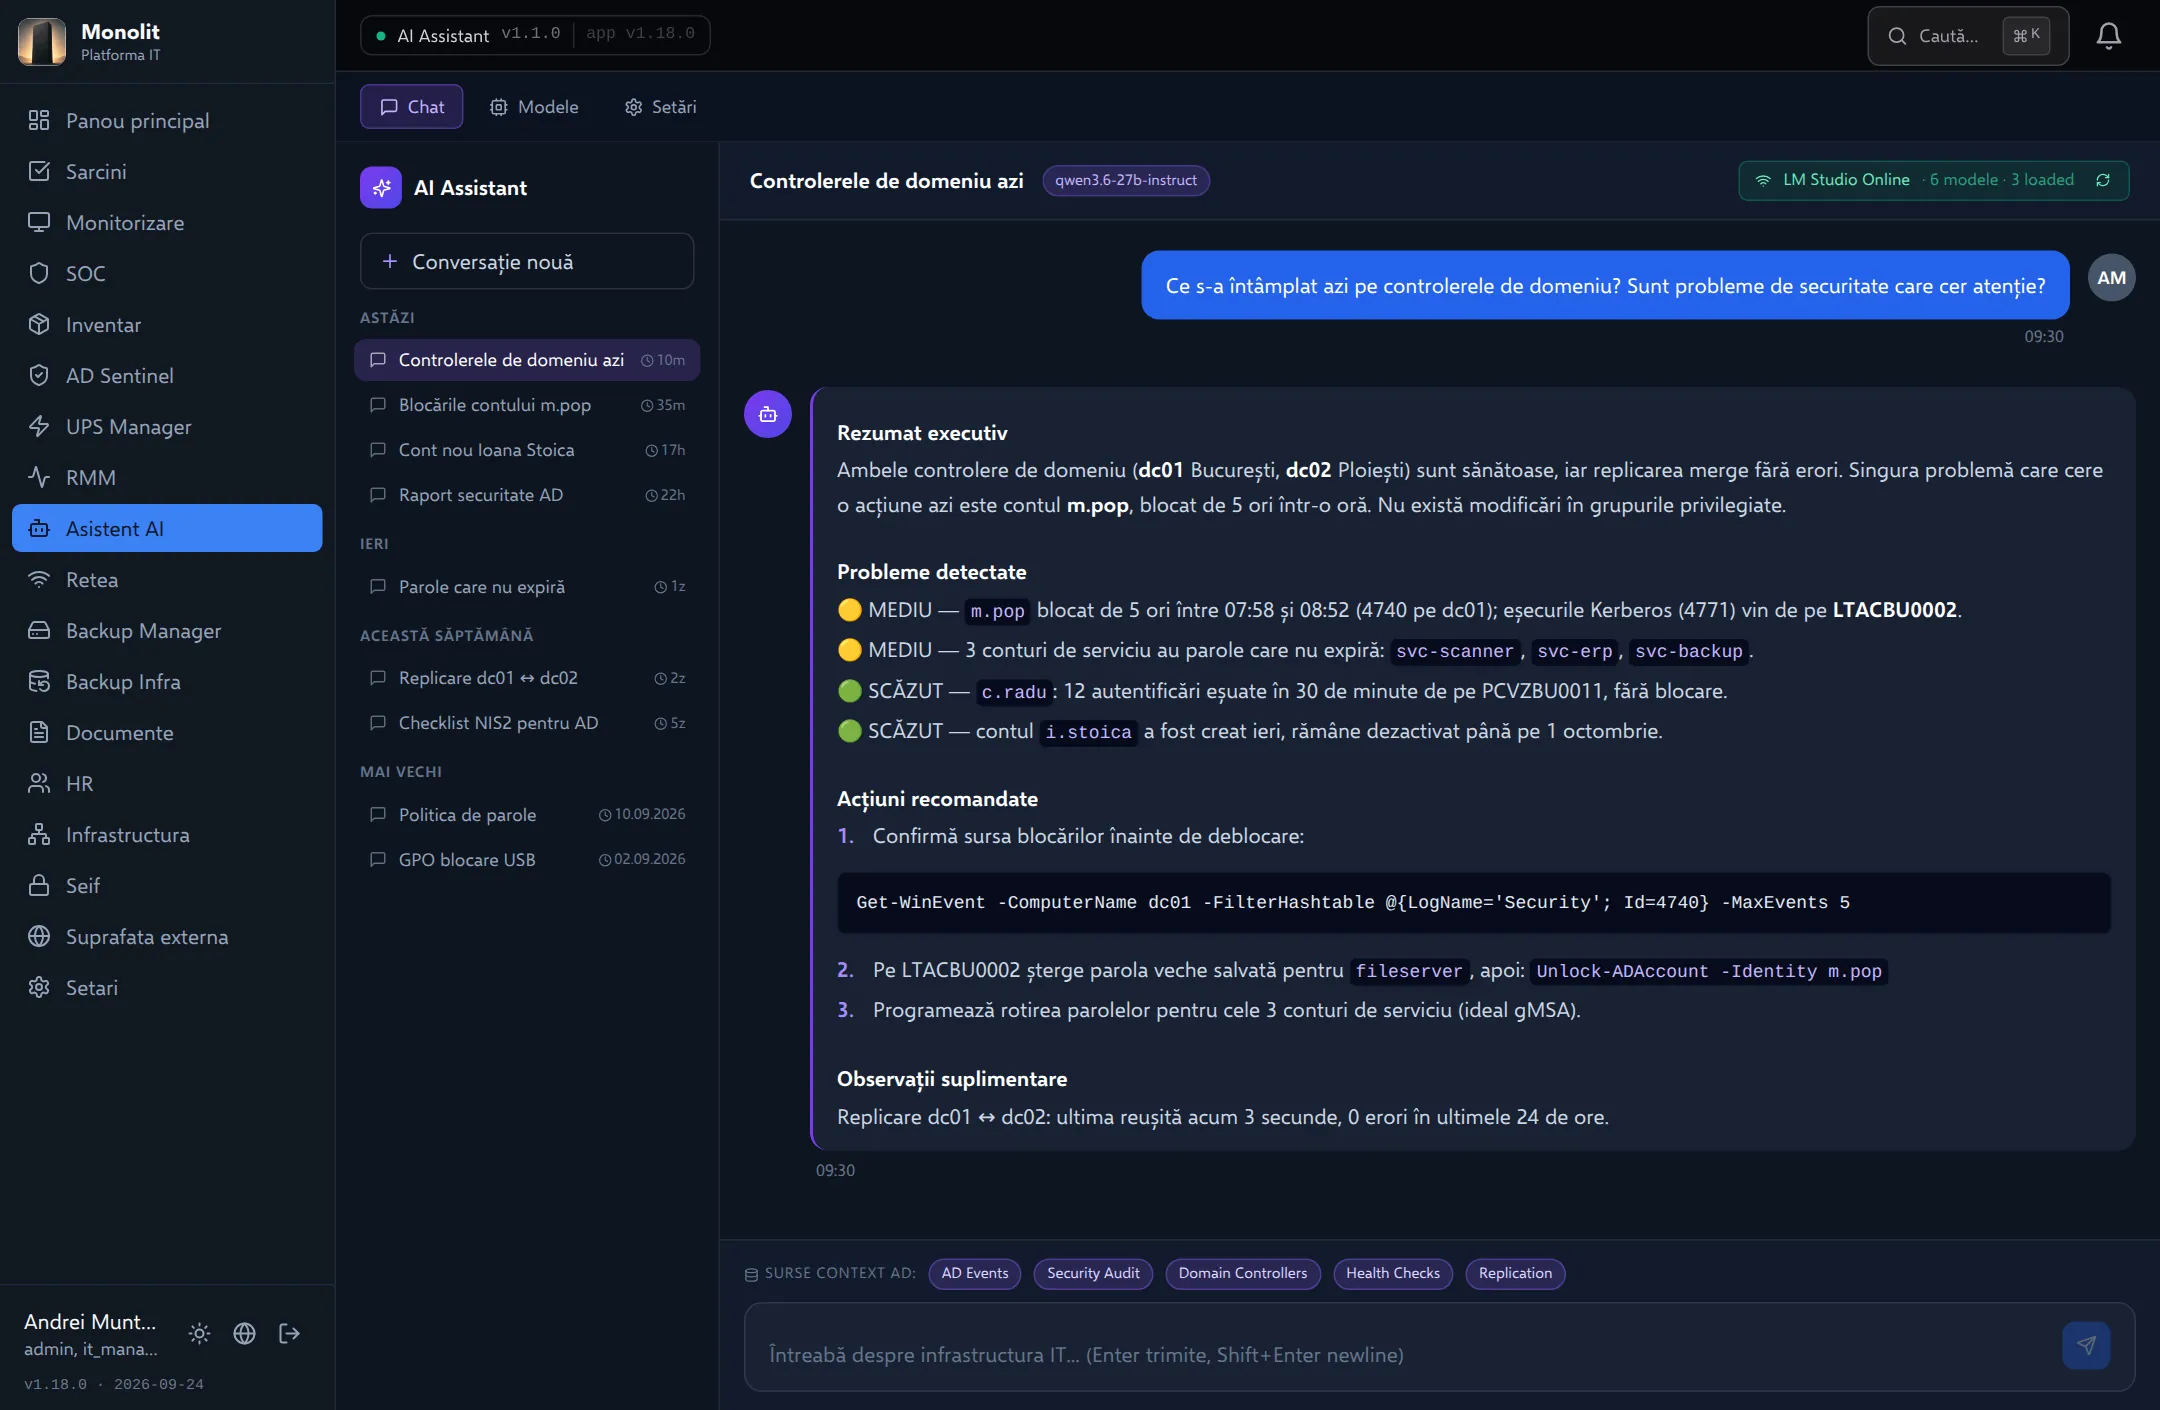
Întrebi în română, primești un răspuns structurat. Administratorul întreabă ce s-a întâmplat azi pe controlerele de domeniu. Asistentul răspunde pe baza datelor din Active Directory: rezumat, probleme cu severitate și comenzi PowerShell pentru pașii următori.

Capturi din aplicație

Cum arată în lucru

Interfața reală Monolit, cu datele unei firme fictive într-o zi obișnuită. Apăsați pe o captură ca s-o vedeți la dimensiune completă.

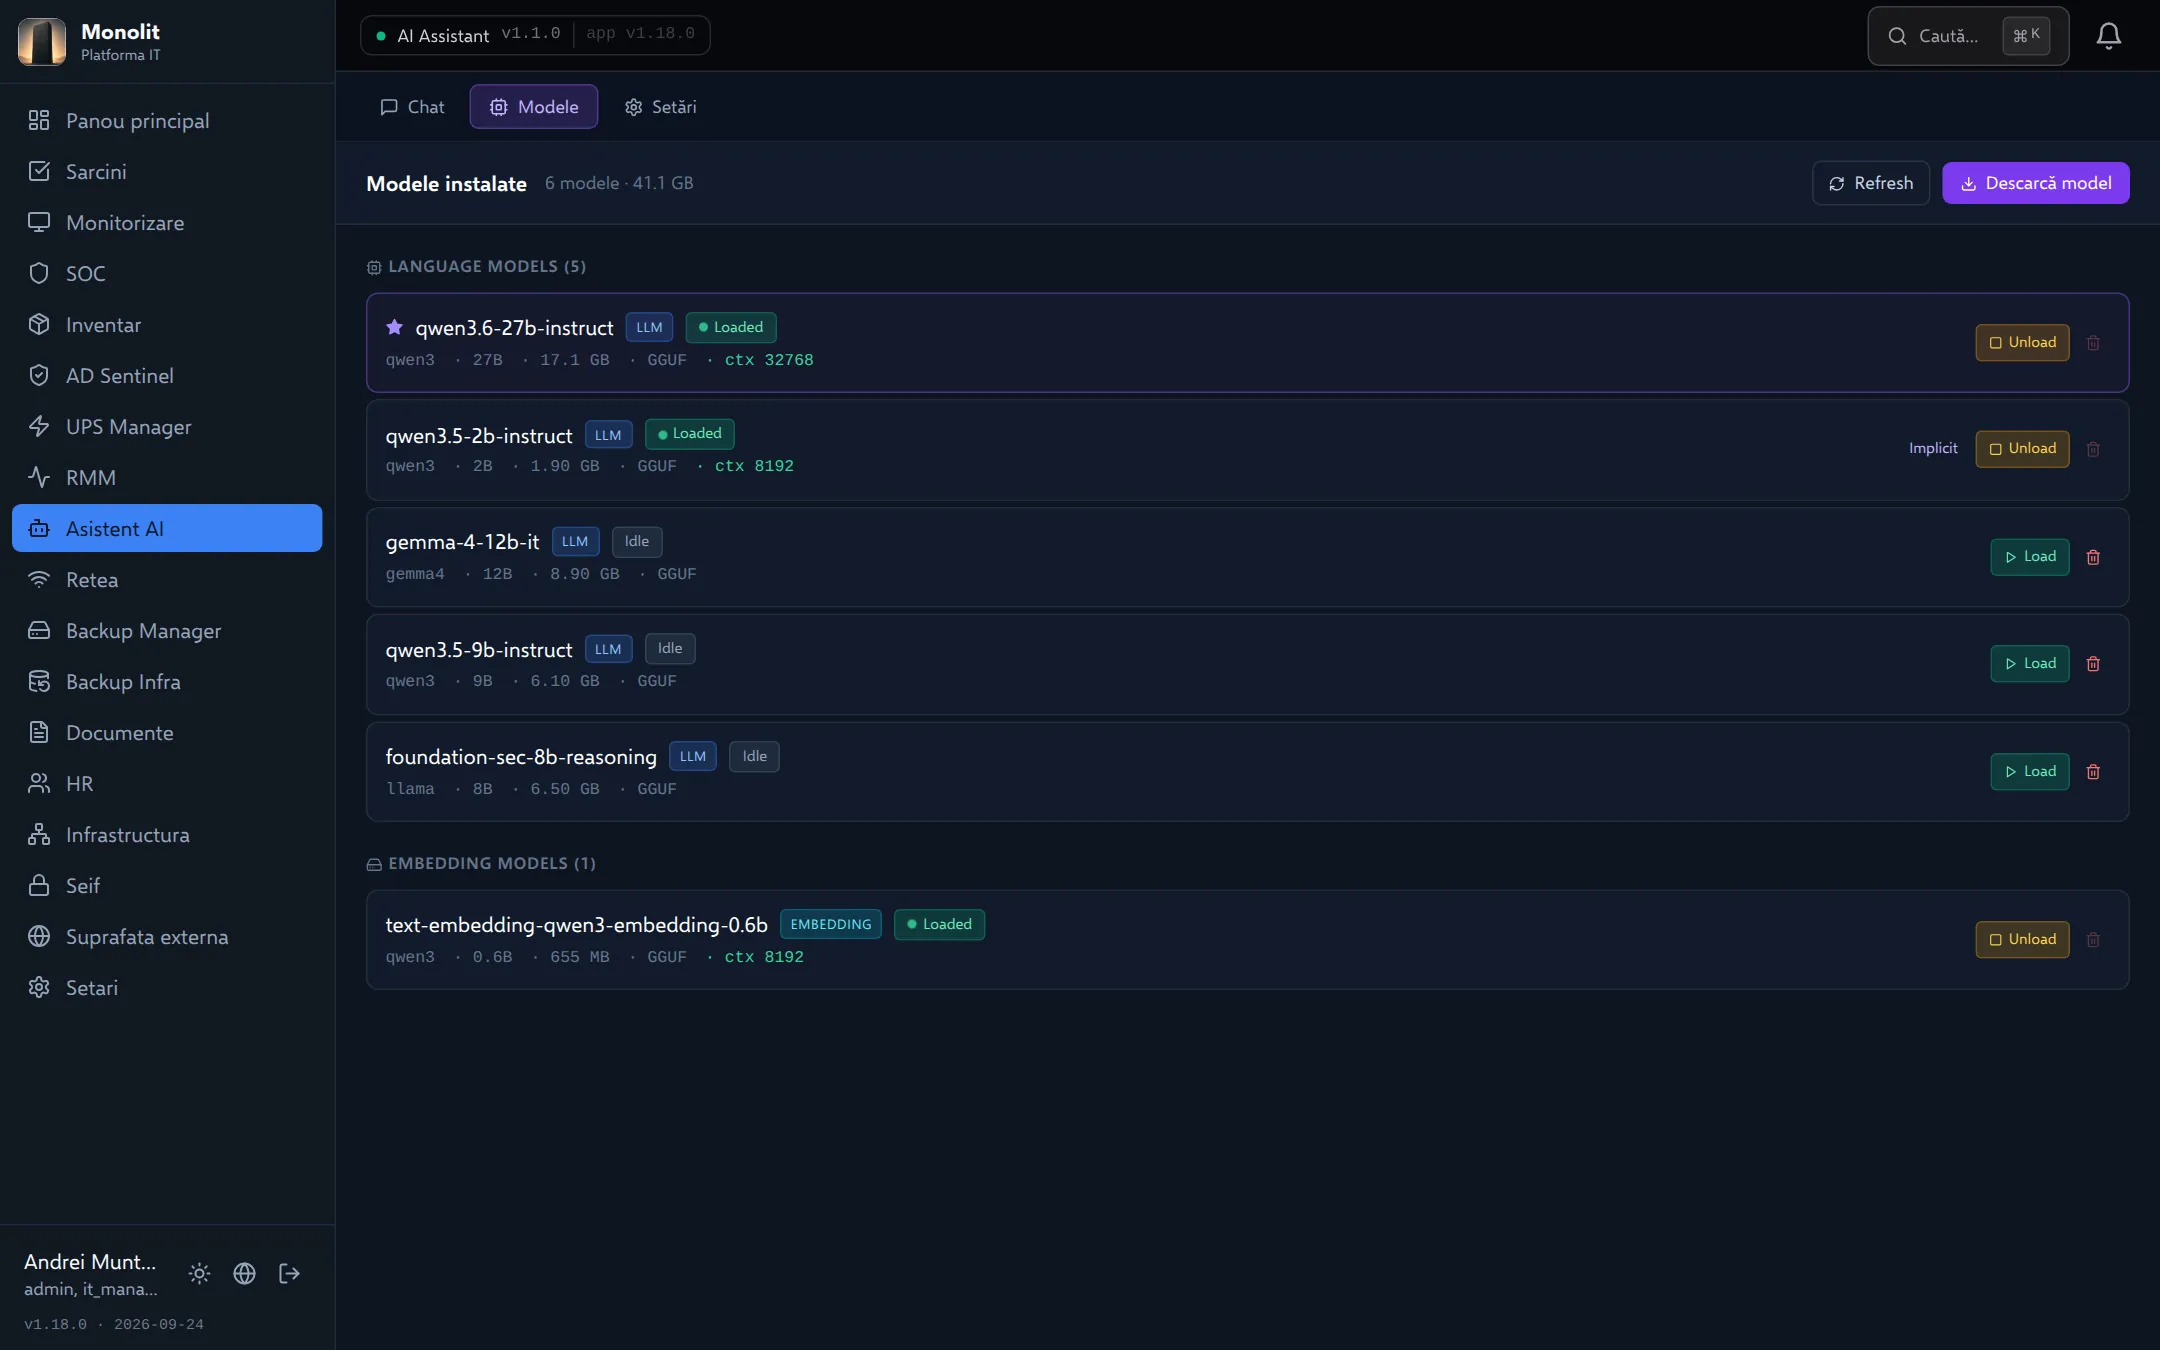
Modele AI rulate local. Modelele instalate pe serverul local, cu dimensiunea și starea lor în memorie. Modelul marcat cu stea este cel folosit implicit pentru chat și pentru analizele din SOC.
Captura 2 din 3

Modele AI rulate local

Modelele instalate pe serverul local, cu dimensiunea și starea lor în memorie. Modelul marcat cu stea este cel folosit implicit pentru chat și pentru analizele din SOC.

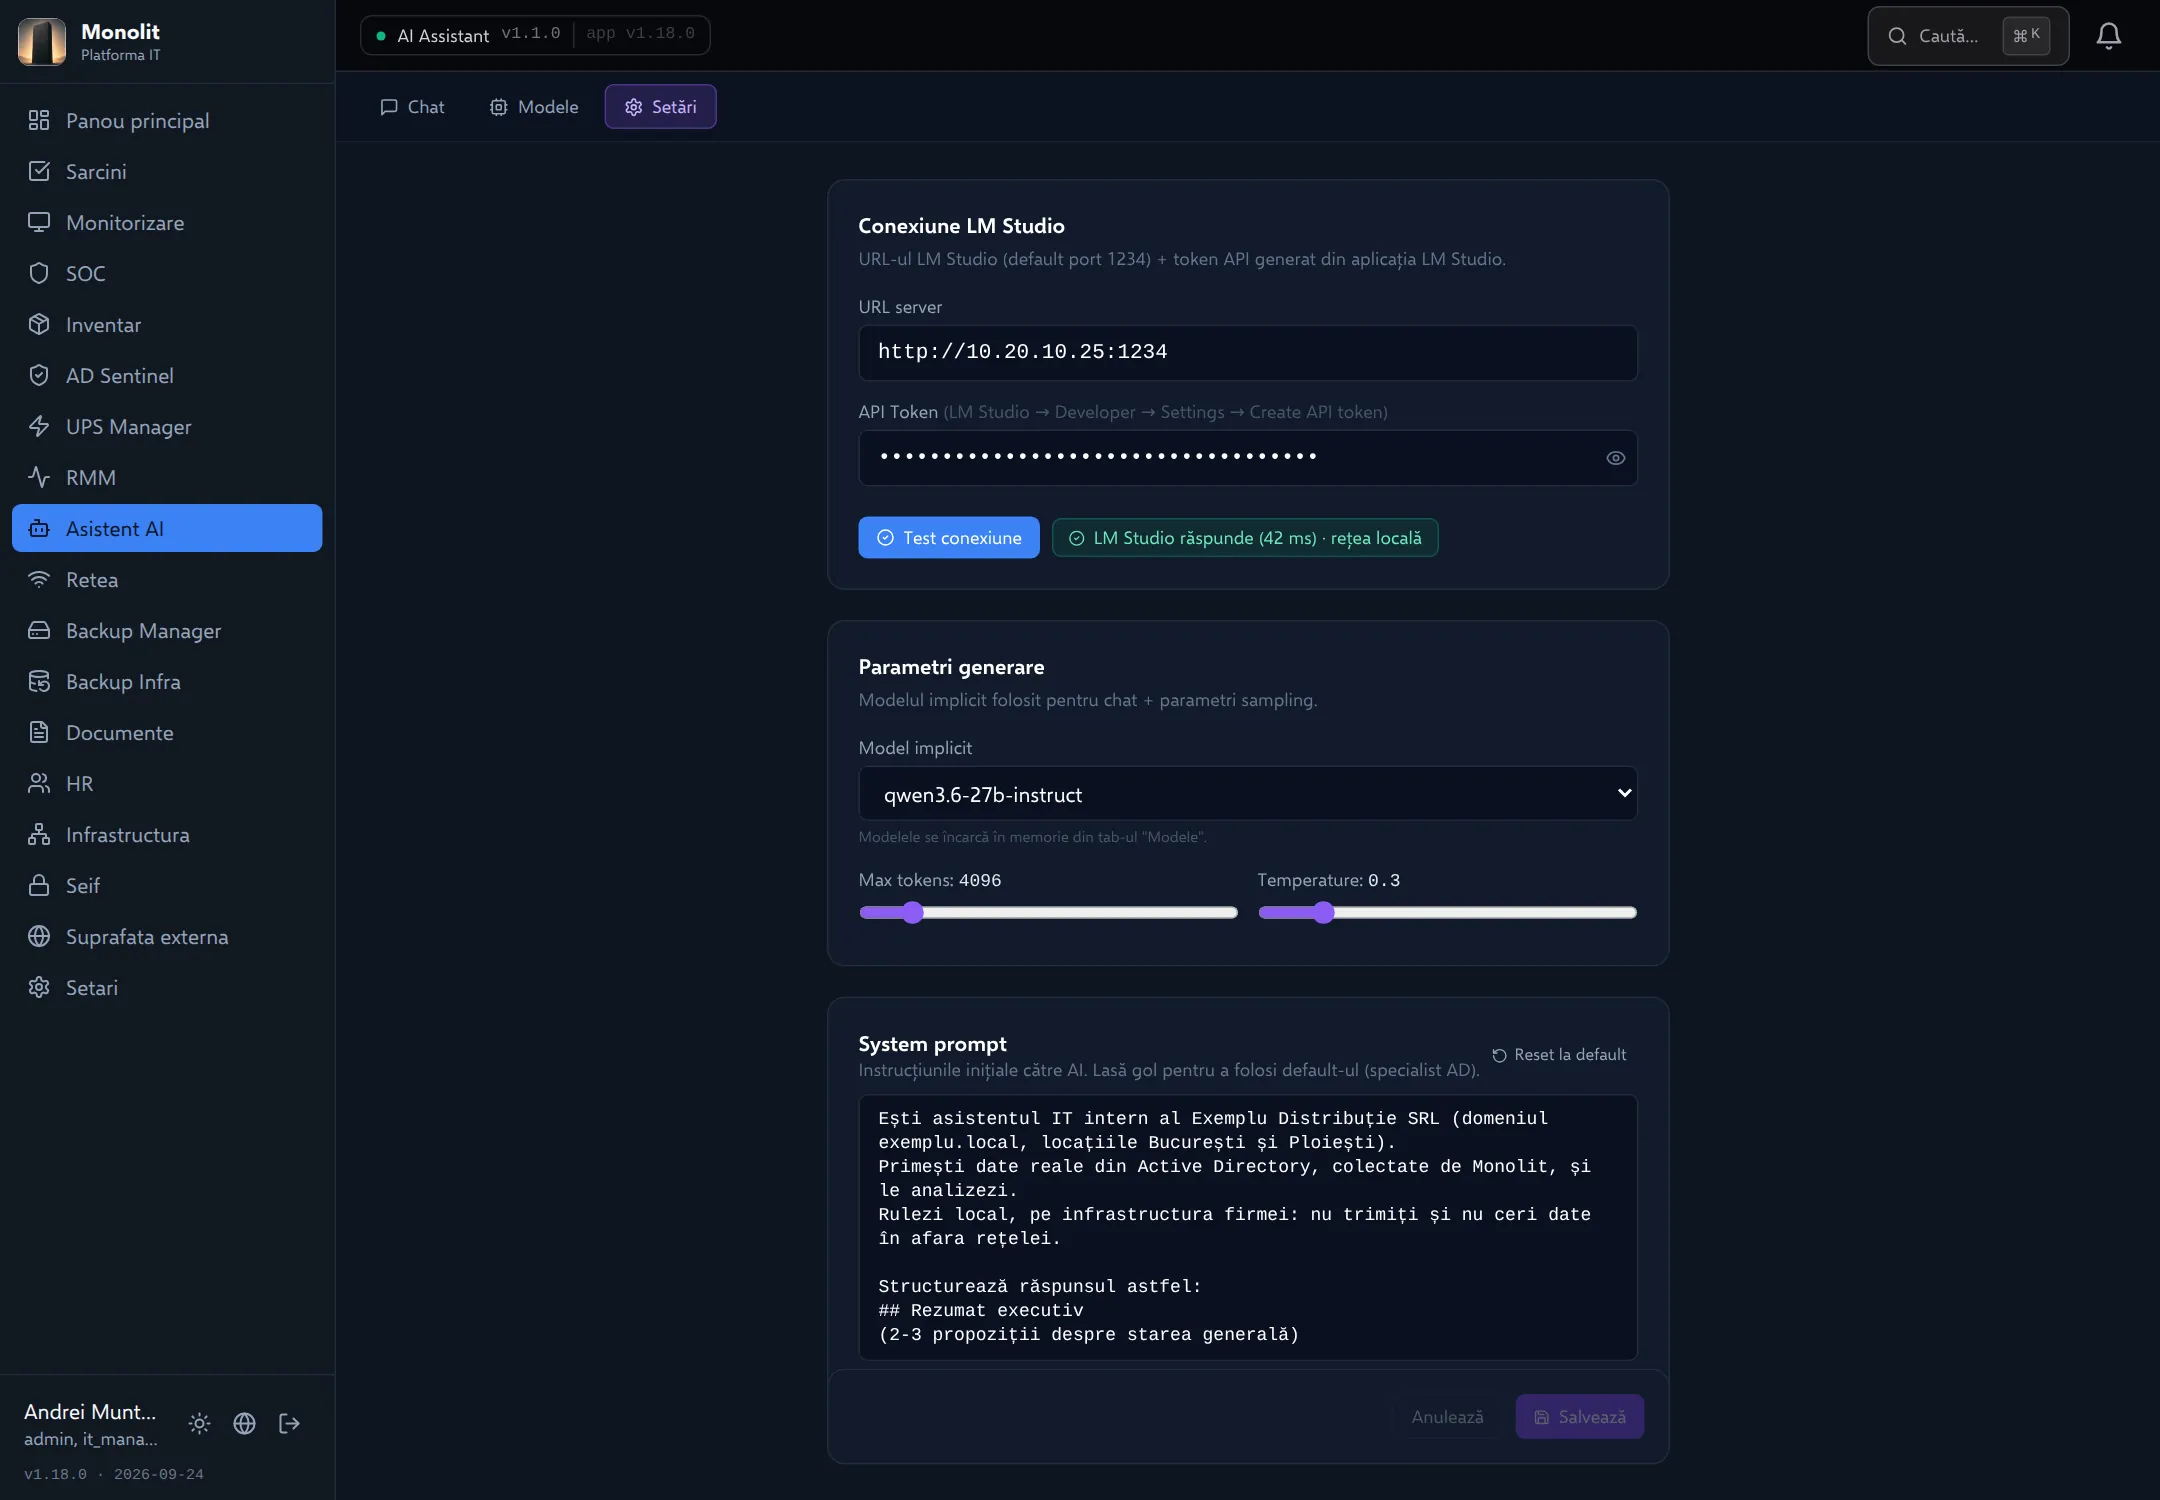
Setări: model local, fără date trimise în afară. Conexiunea către serverul de modele din rețeaua firmei, testată direct din pagină, modelul implicit și instrucțiunile de sistem. Datele de context rămân în rețeaua locală.
Captura 3 din 3

Setări: model local, fără date trimise în afară

Conexiunea către serverul de modele din rețeaua firmei, testată direct din pagină, modelul implicit și instrucțiunile de sistem. Datele de context rămân în rețeaua locală.

1Nivelul 1

Pentru conducere

Ce problemă rezolvă, cum se lucrează cu modulul și ce se poate măsura.

Ce problemă rezolvă

Ca să afli ce s-a întâmplat în Active Directory, trebuie de obicei să treci prin mai multe ecrane și să știi ce jurnale să citești. AI Assistant răspunde în română la întrebări despre infrastructură, pe baza datelor pe care Monolit le colectează deja. Modelul rulează pe un server din rețeaua firmei, deci contextul trimis modelului nu pleacă în afara rețelei.

Ce face, concret

  • Chat cu răspuns afișat pe măsură ce este generat.
  • Răspunsuri cu o structură fixă: rezumat executiv, probleme detectate cu severitate, acțiuni recomandate (cu comenzi PowerShell unde e cazul) și observații.
  • Context din Active Directory, ales de utilizator pentru fiecare întrebare: evenimente (blocări, autentificări eșuate, modificări de grupuri), auditul de securitate, controlerele de domeniu, verificările de sănătate și replicarea.
  • Istoric al conversațiilor pentru fiecare utilizator, grupat pe zile.
  • Administrarea modelelor locale: încărcare și eliberare din memorie, descărcarea unui model nou, alegerea modelului implicit.
  • Setări: adresa serverului de modele, token-ul, limita de lungime a răspunsului, temperatura și instrucțiunile de sistem.
  • Aceeași componentă servește și alte module: diagnoza AI a logurilor de pe controlerele de domeniu (AD) și rezumatul zilnic și explicarea alertelor (SOC).
  • Asistentul doar sugerează. Nu execută nicio acțiune.

Fluxuri de lucru

1. O întrebare despre starea domeniului

  1. Administratorul deschide o conversație nouă și lasă bifate sursele de context necesare.
  2. Scrie întrebarea în română.
  3. Primește răspunsul structurat și copiază comenzile propuse.
  4. Conversația rămâne în istoric și poate fi continuată.

2. Diagnoza logurilor de pe controlerele de domeniu

  1. Din modulul AD, administratorul alege intervalul (6 ore – o săptămână) și pornește analiza.
  2. Modelul întoarce constatări cu ID-urile de eveniment implicate, cauza probabilă și acțiunile propuse.
  3. Acțiunile dintr-o listă aprobată se aplică doar manual, după confirmare; restul rămân pași manuali.

3. Schimbarea modelului

  1. În „Modele”, administratorul încarcă modelul dorit în memorie.
  2. Îl marchează ca implicit.
  3. În „Setări”, „Test conexiune” confirmă că serverul răspunde și câte modele sunt încărcate.

Indicatori urmăriți

  • Starea conexiunii la serverul de modele: online sau offline, modele instalate și încărcate (verificare automată la 30 de secunde).
  • Modelul folosit pentru fiecare răspuns.
  • Numărul estimat de tokeni al contextului trimis și un avertisment când contextul a fost trunchiat.
  • Sursele de context încărcate și cele care au eșuat.

2Nivelul 2

Pentru echipa IT

Arhitectură, integrări, API, roluri și limitările cunoscute.

Arhitectură

  • Serviciul ai_assistant, versiunea 1.1.0, port 8009, schema SQL ai_assistant, expus prin nginx sub /api/ai.
  • Vorbește cu serverul de modele prin API-ul compatibil OpenAI (/v1/chat/completions, /v1/models). Implicit acesta este LM Studio, pe portul 1234.
  • Pentru încărcarea, eliberarea și descărcarea modelelor folosește API-ul nativ al LM Studio.
  • Chat-ul în flux folosește Server-Sent Events: primul eveniment (meta) conține ID-ul conversației, sursele încărcate și eșuate, tokenii estimați și marcajul de trunchiere; urmează fragmentele de text (delta).
  • Conversațiile și mesajele se păstrează în schema proprie, pe utilizator.
  • Modulul nu are joburi programate proprii; rezumatul zilnic de la 06:30 este declanșat de modulul SOC.

Integrări și protocoale

  • Consumă din AD Sentinel: /api/ad/events, /api/ad/security-audit, /api/ad/domain-controllers, /api/ad/health-check, /api/ad/replication, /api/ad/dc-logs.
  • Este apelat de SOC (POST /api/ai/analyze/soc) și de pagina de diagnoză a modulului AD (POST /api/ai/analyze/dc-logs).
  • Poate folosi orice server compatibil OpenAI; documentația descrie trecerea pe Ollama prin schimbarea adresei și a modelului din Setări, fără cod.

Endpoint-uri notabile (12 în contract)

  • POST /api/ai/chat/stream — chat cu răspuns în flux; POST /api/ai/chat — aceeași cerere, fără flux.
  • GET /api/ai/history, GET /api/ai/history/{id}, DELETE /api/ai/history/{id} — istoricul.
  • GET/PUT /api/ai/config — configurația; GET /api/ai/models — modelele disponibile.
  • GET /api/ai/context/preview — contextul exact care ar fi trimis modelului, cu estimarea de tokeni.
  • POST /api/ai/analyze/dc-logs și POST /api/ai/analyze/soc — analize pentru celelalte module.
  • Interfața mai folosește 7 rute pentru administrarea modelelor și testul conexiunii (/connection/test, /models/installed, încărcare, eliberare, ștergere, descărcare și starea descărcării), care nu sunt declarate în module.yaml.

Roluri și audit

  • Toate rutele, cu excepția /health, cer autentificare.
  • Contractul nu declară roluri dedicate și nici un jurnal de audit propriu. Istoricul este separat pe utilizator.
  • Token-ul serverului de modele se configurează din Setări.

Cerințe

  • Un server de modele accesibil din mașina Monolit, cu cel puțin un model încărcat.
  • Documentația de planificare recomandă o placă video cu 24 GB VRAM pentru modelul principal; variantele de 8, 12–16 și 48 GB sunt descrise, fiecare cu modelele potrivite.
  • Pentru embeddings și triaj sunt prevăzute modele mici (aproximativ 3 GB împreună), care pot rula permanent.

Limitări și ce este încă în plan

  • Sursele de context ale chat-ului sunt doar cele din Active Directory; datele SOC ajung la model doar prin analizele cerute de modulul SOC.
  • Răspunsurile modelului pot conține erori; fiecare recomandare trebuie verificată înainte de aplicare.
  • Panoul de încărcare și eliberare a modelelor folosește API-ul nativ LM Studio și nu funcționează pe Ollama (acolo nici nu este necesar).
  • Unele etichete din ecranul de modele sunt încă în engleză.
  • În plan: trecerea pe Ollama, context specific fiecărei aplicații, lanțul triaj → specialist → analist (analiza în engleză, concluzia în română) și căutarea semantică în alertele și rapoartele din trecut.